原帖 | Jason | 2026-05-15 11:34 | 👍0 | 阅读约1
🔥 所有大模型的“祖宗”:Transformer
你每天用的 GPT、deepseek、Claude,底层全是它——Transformer。
2017年谷歌一篇《》直接炸翻AI圈,没有它就没有今天的大模型。
🧠 一句话讲透
Transformer = 让AI会“抓重点+看全局”的超级神经网络。不用逐字读,一眼看懂整段话,还能记住谁和谁有关系。
🆚 以前的AI有多笨?
-
RNN/LSTM:像老和尚念经,一字一句读,长文必忘,巨慢
-
Transformer:像聪明读者,整段并行看,自动圈重点,超快
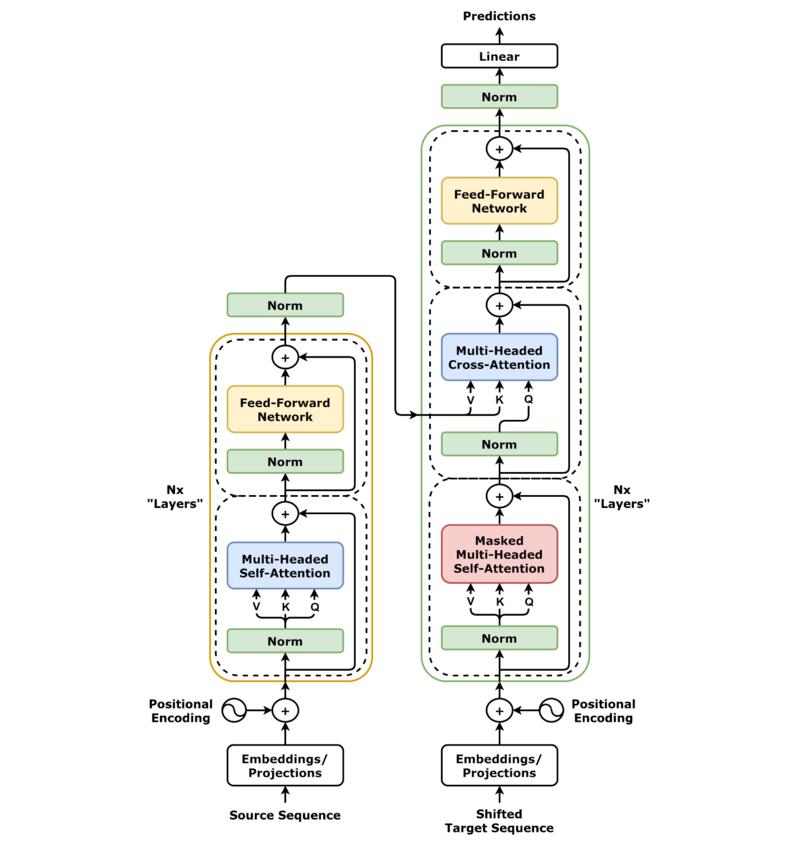
🏗️ 核心结构
1. 词嵌入:给每个词发“语义身份证”
2. 位置编码:AI不认顺序,贴“座位号”防搞反
3. 编码器:吃透原文,抓上下文关系
4. 解码器:生成回答,不准偷看未来
5. 自注意力:灵魂!计算谁和谁更相关
6. 多头注意力:多视角抓重点,更聪明
✨ 为什么它是大模型地基?
- 超快:全并行,训练速度碾压旧模型
- 超长:轻松搞定长文本,不丢信息
- 超强:全局抓关系,理解上下文无敌
- 超通用:文本、图像、语音全能用
💡 小白总结
Transformer = 大模型的骨架+大脑
看懂它,你就看懂了 90% 的AI大模型。
相关笔记
- 📁 返回本主题 MOC
- AI 核心概念扫盲
- Matt Pocock Skills零基础入门教程
- 现在用 Claude、Cursor 写代码,Token 跑得飞快
- 分享 Claude Code 里 :goal 命令的实用玩法,零基础也能直接上手
- 之前我们完整梳理过 AI 应用商业级落地的核心技术栈
- 企业级 AI 落地方案,不管是昨天分享的 agent + MCP + skills